쿠버네티스 파드가 Pending인 이유는? 원인 확인과 해결 순서
 noaDevOps Engineer
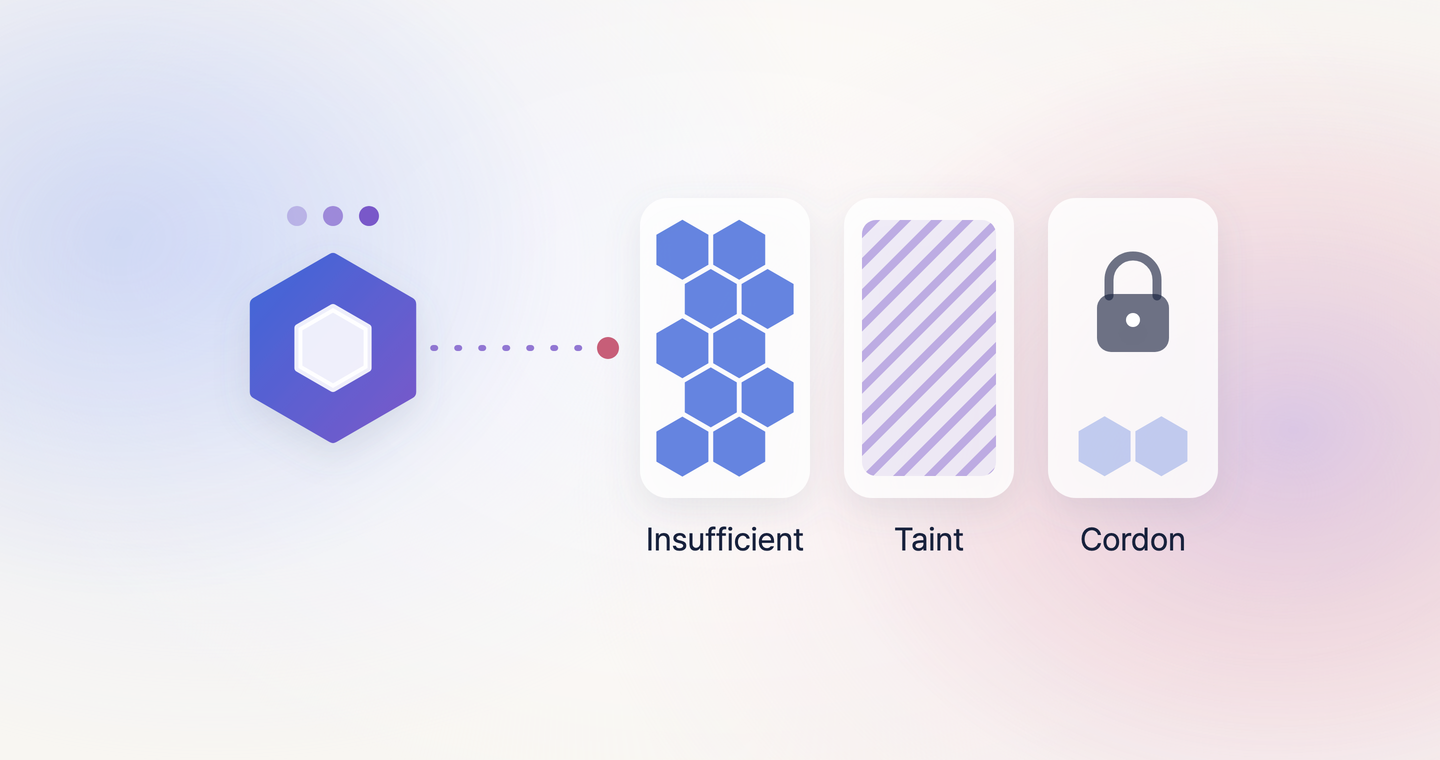
쿠버네티스 파드가 Pending이라는 것은 파드를 실행할 노드가 아직 정해지지 않았거나, 노드는 정해졌지만 이미지 다운로드 같은 실행 준비가 끝나지 않았다는 뜻입니다. 노드를 정하지 못한 경우라면 파드 상세 정보 맨 아래 Events에 FailedScheduling 이벤트가 남고, 같은 줄 메시지에 원인이 나옵니다.
kubectl describe pod의 출력 예시입니다(Kubernetes 1.37 기준). 중간 항목은 생략했습니다. Node가 <none>이면 아직 노드가 정해지지 않은 상태입니다.
출력 맨 아래 Events에서 Reason이 FailedScheduling인 줄의 메시지를 읽고, 다음 목록에서 같은 문구를 찾아 그 항목의 할 일을 확인합니다.
- Insufficient cpu, Insufficient memory: 노드에 새 파드를 받을 여유가 남지 않았다는 뜻입니다. 파드의 requests(식당 예약석처럼 파드가 미리 잡아 두는 자원 양)가 너무 크지 않은지 확인하고, requests를 줄이거나 노드를 추가합니다.
- didn't match Pod's node affinity/selector: 파드가 원하는 이름표(라벨)를 단 노드가 없다는 뜻입니다. 파드에 건 노드 조건과 노드 라벨을 비교해 틀린 쪽을 고칩니다.
- had untolerated taint(s): 노드 문에 붙은 출입 제한 표시(테인트)가 파드를 막았다는 뜻입니다. 그 노드에 들어가도 되는 파드라면 파드에 출입증(톨러레이션)을 추가합니다.
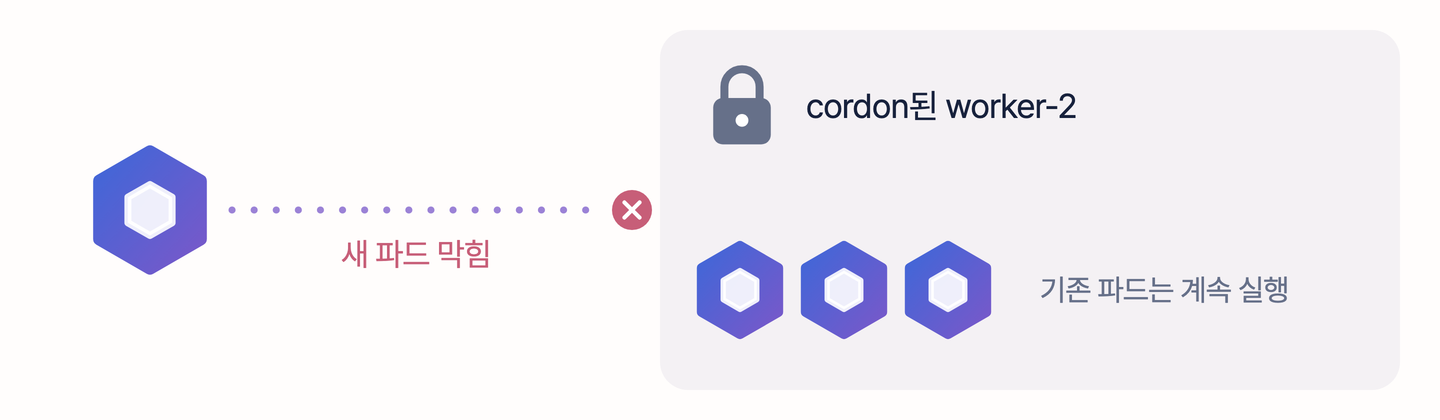
- were unschedulable: 관리자가 점검하려고 새 파드를 받지 않게 막아 둔(cordon) 노드라는 뜻입니다. 점검이 끝났다면 kubectl uncordon worker-2처럼 노드 이름을 넣어 노드를 다시 엽니다.
- pod has unbound immediate PersistentVolumeClaims: 파드가 쓸 디스크 요청서(PVC)가 아직 실제 디스크와 연결되지 않았다는 뜻입니다.
kubectl describe pvc web-data -n shop으로 PVC 이벤트를 열어 연결되지 않은 이유를 찾습니다.
메시지별로 무엇을 확인하고 어떻게 고치는지 하나씩 살펴보겠습니다.
FailedScheduling 메시지별 Pending 원인과 해결 방법
Insufficient cpu, Insufficient memory
Insufficient cpu나 Insufficient memory가 보이면 파드가 요청한 양과 노드에 남은 예약 여유를 비교하고, 파드의 requests를 줄이거나 노드를 추가합니다.
파드를 놓을 노드를 고르는 스케줄러는 노드의 지금 사용량 대신 파드가 미리 예약해 둔 양(requests)으로 남은 여유를 계산합니다. 식당에서 손님이 아직 오지 않았어도 예약석을 다른 손님에게 내주지 않는 것과 같은 방식입니다.
노드가 파드에 내줄 수 있는 자원을 할당 가능량(allocatable)이라고 합니다. 예를 들어 메모리 할당 가능량이 8Gi이고 기존 파드들이 6Gi를 예약했다면, 남은 예약 공간은 2Gi입니다. 새 파드가 3Gi를 요청하면 실제 메모리 사용률이 낮아도 배치되지 않습니다.
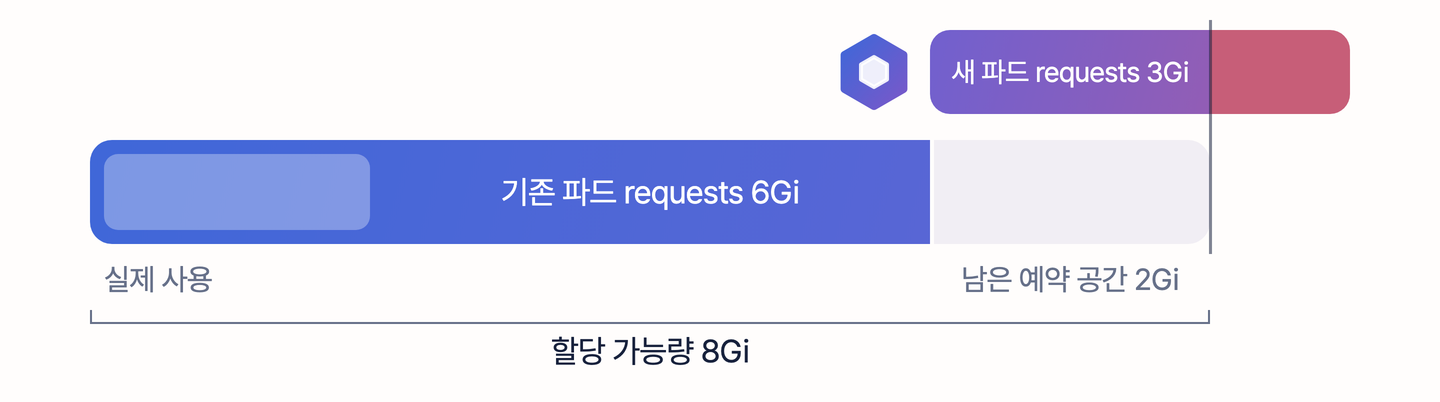
파드가 요청한 양은 kubectl describe pod의 Containers와 Init Containers에서, 노드에 이미 예약된 양은 kubectl describe nodes(노드 읽기 권한 필요)의 Allocated resources에서 확인합니다. 아래는 메모리 할당 가능량이 8Gi인 노드의 예시입니다.
Requests 열이 이미 예약된 양이고, 스케줄러가 배치를 판단할 때 비교하는 값도 Requests입니다. Limits는 컨테이너가 사용할 수 있는 상한의 합계라 100%를 넘기도 합니다. 일반 컨테이너의 requests가 작아도, 본 컨테이너보다 먼저 실행되는 준비용 init 컨테이너의 요청량이 크면 그 값 때문에 배치가 막힐 수 있습니다.
requests를 얼마로 줄일지는 실제 사용량을 보고 정합니다(쿠버네티스 리소스 설정 튜닝 사례).
didn't match Pod's node affinity/selector
didn't match Pod's node affinity/selector가 보이면 파드에 건 노드 조건과 노드 라벨(노드에 붙인 이름표)을 나란히 놓고 비교합니다. 파드에는 "이 이름표가 붙은 노드로만 가라" 같은 조건을 걸 수 있고, 조건에 맞는 노드가 없으면 파드는 기다립니다.
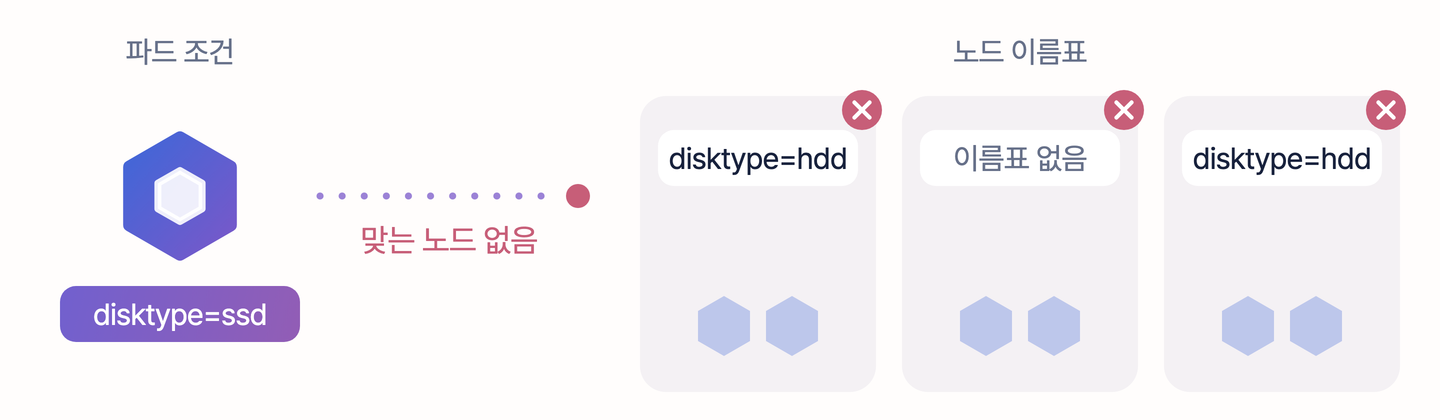
노드 셀렉터(nodeSelector)든 노드 어피니티(node affinity)든 맞는 노드가 없으면 같은 메시지가 나옵니다. kubectl get pod web-7d9f8 -n shop -o yaml에서 본 nodeSelector, affinity와 kubectl get nodes -L disktype로 본 노드 라벨을 비교합니다. disktype 대신 파드 조건에 쓴 라벨 이름을 넣습니다.
라벨 값이 다르거나 새 노드에 필요한 라벨이 빠졌다면, 의도한 배치 조건에 맞게 파드 설정이나 노드 라벨을 고칩니다. 노드 어피니티 가운데 배치를 막는 규칙은 반드시 지켜야 하는 required 규칙뿐이고, 되도록 지키면 되는 preferred 규칙만 있으면 맞는 노드가 없어도 파드는 다른 노드에 배치됩니다.
had untolerated taint(s)
had untolerated taint(s)가 보이면 테인트(노드 문에 붙은 출입 제한 표시)가 붙은 노드에 이 파드를 배치해도 되는지부터 정합니다. 배치해도 되는 파드라면 파드에 톨러레이션(테인트를 통과하는 출입증)을 추가합니다. 노드 문에는 "GPU 작업용 파드만 받음" 같은 출입 제한 표시를 붙일 수 있고, 맞는 출입증이 없는 파드는 그 노드에 들어가지 못합니다.
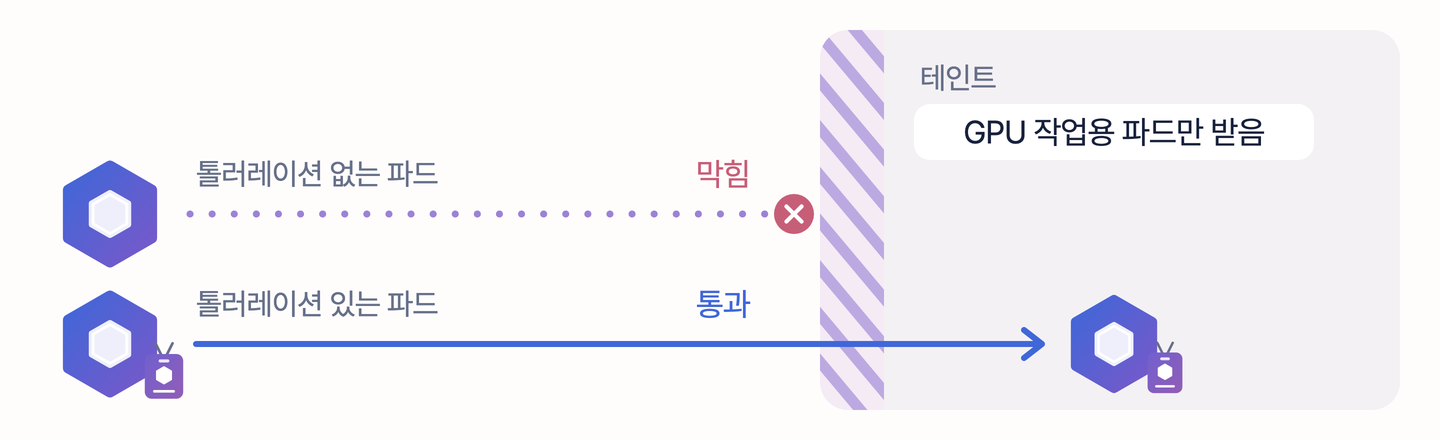
Kubernetes 1.35부터는 이벤트에 테인트 키와 값이 나오지 않으므로 노드 설정을 직접 봅니다. kubectl get nodes -o custom-columns='NAME:.metadata.name,TAINTS:.spec.taints'로 본 노드의 테인트와 파드 YAML의 tolerations를 비교합니다.
전용 노드에 들어가야 하는 파드라면 파드 템플릿의 tolerations를 노드의 테인트에 맞춥니다.
노드가 준비되지 않았거나 메모리, 디스크가 모자라면 쿠버네티스가 node.kubernetes.io/not-ready 같은 테인트를 직접 붙입니다. 이때는 톨러레이션을 추가하기 전에 kubectl describe node worker-2의 Conditions에서 노드 상태부터 확인합니다.
were unschedulable
were unschedulable이 보이면 노드가 cordon(점검하려고 새 파드를 받지 않게 막아 둔 상태)인지 확인하고, 점검이 끝난 노드라면 kubectl uncordon worker-2로 다시 파드를 받게 합니다. cordon된 노드는 kubectl describe node worker-2에서 Unschedulable: true로 보입니다.
unbound immediate PersistentVolumeClaims
pod has unbound immediate PersistentVolumeClaims가 보이면 kubectl describe pvc web-data -n shop의 이벤트에서 디스크가 연결되지 않은 이유를 찾습니다. 파드가 저장 공간 요청서(PVC, PersistentVolumeClaim)를 냈는데 실제 디스크(PV, PersistentVolume)와 연결되지 않으면 파드는 기다립니다. PVC와 PV를 연결하는 일을 바인딩이라고 합니다.
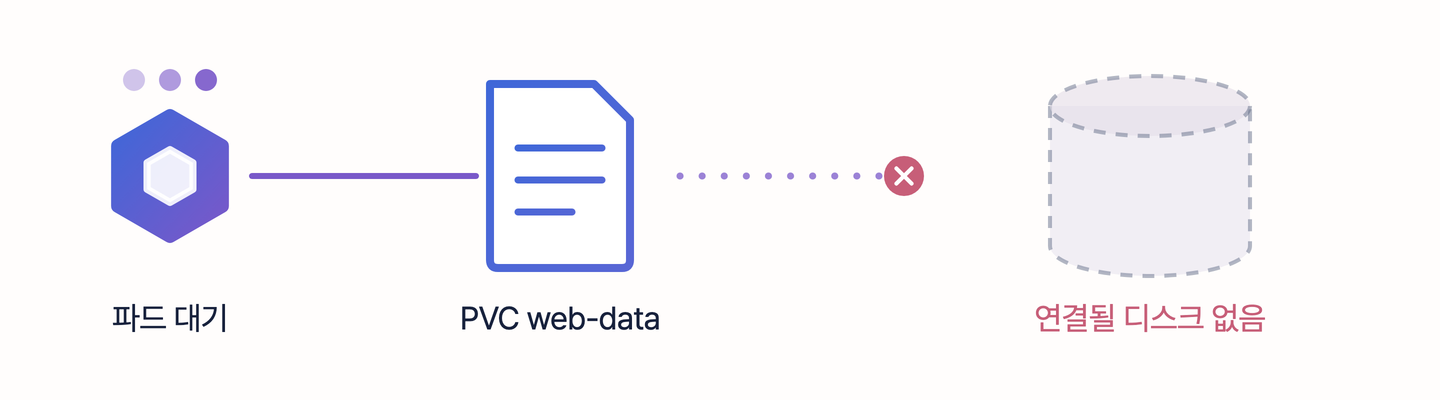
파드 이벤트에 persistentvolumeclaim "web-data" not found가 보이면 파드의 volumes에 지정한 PVC 이름과 같은 네임스페이스에 실제로 존재하는 PVC를 비교합니다. 그 밖에 자주 보이는 PVC 이벤트는 다음과 같습니다.
스토리지 클래스가 없다면 kubectl get storageclass로 사용 가능한 클래스를 확인하고, ProvisioningFailed라면 오류 내용에 따라 용량, 권한, 스토리지 설정을 봅니다.
waiting for first consumer와 waiting for pod web-7d9f8 to be scheduled는 파드의 노드가 먼저 정해지기를 기다린다는 뜻이고 오류는 아닙니다. 파드의 FailedScheduling 메시지에서 배치를 막는 다른 원인을 찾습니다.
고쳤는데도 파드가 계속 Pending일 때
노드 메모리 사용률은 낮은데 Insufficient memory가 나올 때
메모리가 절반도 차지 않았는데 Insufficient memory가 나오면 kubectl describe nodes의 Allocated resources에서 Requests 비율을 봅니다. kubectl top node는 지금 쓰는 양을 보여 주지만 스케줄러는 requests 합계로 판단하므로, requests를 넉넉하게 잡은 파드가 많으면 사용률이 38%여도 requests 합계는 100%에 가까울 수 있습니다.
톨러레이션을 넣었더니 Insufficient memory가 새로 나올 때
Pending 원인 하나를 고친 뒤에는 kubectl describe pod로 이벤트를 다시 확인합니다. 스케줄러는 노드마다 여러 조건을 정해진 순서대로 검사하고, 서류 심사에서 떨어진 지원자를 면접에 부르지 않듯 한 조건에서 떨어진 노드는 다음 조건을 검사하지 않습니다. 그래서 원인 하나를 고치면, 먼저 검사하는 조건에서 탈락하느라 확인되지 못했던 다른 원인이 드러나기도 합니다.
기본 스케줄러는 테인트(노드의 출입 제한 표시)를 자원보다 먼저 검사합니다. 톨러레이션(테인트를 통과하는 출입증)을 넣고 나서 같은 노드가 Insufficient memory로 집계된다면, 기존 자원 부족이 이제 드러난 것입니다.
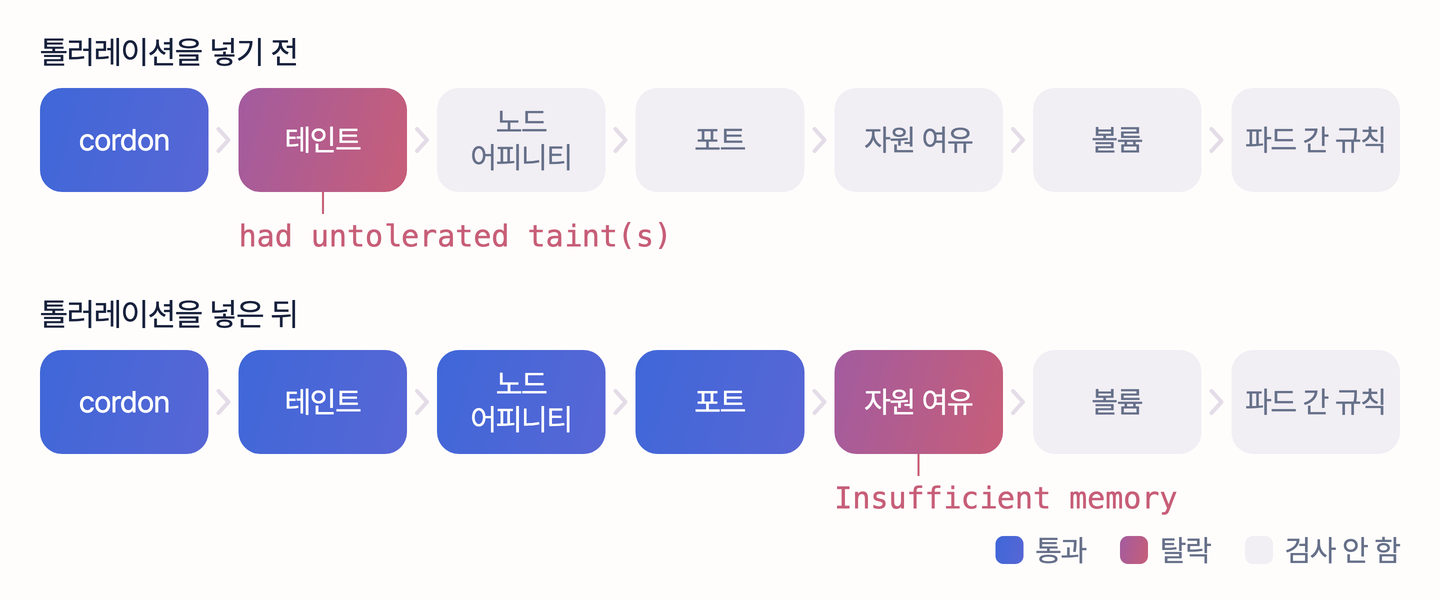
그림의 포트, 볼륨, 파드 간 규칙 칸은 이 글에서 다루지 않는 검사입니다.
FailedScheduling이 보이지 않을 때 함께 볼 두 가지
FailedScheduling 메시지가 없고 Node 항목에 노드 이름이 있거나 파드가 아예 없다면, 원인은 노드 배정 밖에 있습니다. 자주 만나는 경우는 노드가 정해진 뒤 시작이 멈춘 경우와, 파드가 아예 만들어지지 않은 경우입니다.
노드는 정해졌는데 파드가 시작되지 않을 때
kubectl describe pod의 Node 항목에 노드 이름이 있으면 노드 배정은 끝났고, 그 노드에서 컨테이너를 준비하다 멈춘 것입니다. Events에서 Scheduled 다음에 나온 실패 이벤트나 kubectl get pods의 STATUS를 봅니다.
- ErrImagePull, ImagePullBackOff: 이미지를 받지 못했습니다. 원인 4가지는 시리즈 2편 쿠버네티스 ImagePullBackOff 원인 4가지와 kubectl describe 진단법에서 다뤘습니다.
- FailedMount: 볼륨을 붙이지 못했습니다. 메시지에 나온 ConfigMap, Secret이 실제로 있는지 확인합니다.
- STATUS가 Init:0/1: 본 컨테이너보다 먼저 실행되는 준비용 init 컨테이너가 끝나지 않았습니다.
kubectl logs web-7d9f8 -n shop -c init-db로 로그를 봅니다.
파드가 목록에 아예 없을 때, ResourceQuota
Deployment를 만들었는데 파드가 하나도 보이지 않으면 ResourceQuota에 걸렸을 수 있습니다. ResourceQuota는 네임스페이스(팀이나 서비스별로 클러스터를 나눠 쓰는 단위)마다 거는 자원 한도이고, 한도를 넘으면 쿠버네티스가 파드를 아예 만들지 않아 Pending 상태도 남지 않습니다. 거절 이유는 kubectl get events -n shop --field-selector reason=FailedCreate로 봅니다. 한도와 사용량은 kubectl describe resourcequota -n shop로 확인합니다.
자주 묻는 질문
노드가 1대인데 왜 0/1 nodes are available: 1 node(s) had untolerated taint(s)가 나오나요?
그 노드가 컨트롤 플레인 노드라 일반 파드를 받지 않게 하는 출입 제한 표시인 node-role.kubernetes.io/control-plane 테인트가 붙어 있을 수 있습니다. kubeadm으로 노드 1대짜리 클러스터를 만들면 이 테인트가 그대로 남습니다. 운영 클러스터라면 워커 노드를 추가합니다. 실습용 단일 노드 클러스터라면 kubeadm 공식 문서가 안내하는 kubectl taint nodes --all node-role.kubernetes.io/control-plane-로 테인트를 지웁니다.
클러스터 오토스케일러를 쓰는데 Pending이 왜 풀리지 않나요?
파드 이벤트에서 오토스케일러의 판단을 봅니다. TriggeredScaleUp은 이 파드를 위해 노드를 늘리기로 했다는 이벤트라, 새 노드가 준비될 때까지 몇 분간 Pending인 것은 정상입니다. NotTriggerScaleUp은 늘릴 수 있는 노드 그룹을 찾지 못했다는 이벤트입니다. 노드 그룹이 최대 크기에 도달했거나, 새 노드를 만들어도 노드 셀렉터나 테인트 때문에 파드가 들어가지 못하면 이 이벤트가 남습니다.
마치며
파드 Pending 해결은 kubectl describe pod의 Events에서 FailedScheduling 메시지를 읽는 데서 시작합니다. 메시지 문구로 자원, 노드 선택 조건, 테인트와 cordon, PVC 가운데 어디를 고칠지 정합니다. 하나를 고친 뒤에는 메시지를 다시 보고 다음 사유가 드러나는지 확인합니다.
이 글은 쿠버네티스 문제 해결 가이드 4편입니다. 파드가 실행된 뒤 재시작을 반복하면 1편 CrashLoopBackOff 원인 4가지 구분법을, 이미지를 받지 못하면 2편 ImagePullBackOff 원인 4가지와 kubectl describe 진단법을, 메모리 한도를 넘어 종료되면 3편 OOMKilled와 Exit Code 137 원인과 해결 방법을 보면 됩니다.
와탭 쿠버네티스 모니터링에서는 지금 Pending인 파드의 이벤트 메시지와 QoS 클래스를 한 목록에서 보고, 메시지를 바탕으로 한 문제 해결 제안까지 받을 수 있습니다(Pending Pod 현황 문서).
더 읽을거리
- 쿠버네티스 CrashLoopBackOff 원인 4가지 구분법 (쿠버네티스 문제 해결 가이드 1편)
- 쿠버네티스 ImagePullBackOff 원인 4가지와 kubectl describe 진단법 (쿠버네티스 문제 해결 가이드 2편)
- OOMKilled와 Exit Code 137 원인과 해결 방법 (쿠버네티스 문제 해결 가이드 3편)
- 쿠버네티스 모니터링, 4가지 핵심 지표부터 툴 선택까지
- Debug Pods (Kubernetes 공식 문서)
- Assigning Pods to Nodes (Kubernetes 공식 문서)
- Taints and Tolerations (Kubernetes 공식 문서)