문제 해결에 필요한 인사이트를 확인해보세요
장애 때 필요한 로그를 바로 찾으려면? 로그 설정 가이드
장애 때 필요한 로그를 바로 찾으려면 APM이나 트레이싱 도구가 요청마다 만드는 trace_id를 로그 한 줄마다 찍도록 로그 형식을 설정해야 합니다. 도구가 MDC에 넣은 값을 로그 패턴이 꺼내는 원리, Spring Boot와 OpenTelemetry Java 에이전트 설정, 비동기 작업 로그에서 trace_id가 빠질 때 해결 방법을 정리합니다.
GPU 사용률 100%면 성능을 다 쓰는 걸까? SM Active 확인 방법
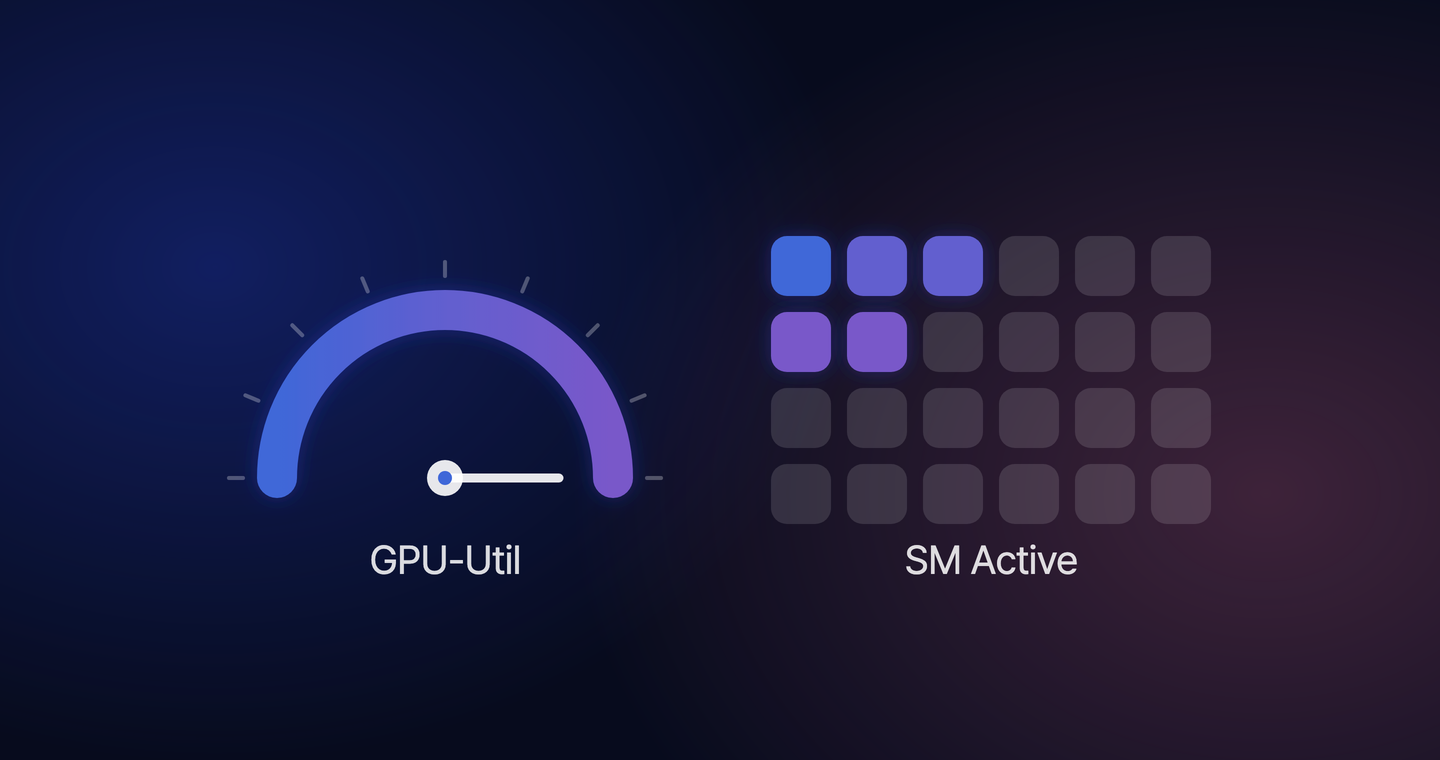
GPU 사용률 100%는 GPU 성능을 다 쓴다는 뜻이 아니라, 측정 구간 내내 계산 작업이 하나 이상 실행됐다는 뜻입니다. dcgmi dmon으로 GPU-Util과 SM Active를 나란히 출력해, 전체 SM이 얼마나 활성 상태였는지 NVIDIA 기준값으로 읽는 방법을 정리했습니다.
쿠버네티스 파드가 Pending인 이유는? 원인 확인과 해결 순서
쿠버네티스 파드가 Pending에 머무는 이유는 실행할 노드를 정하지 못했거나 노드에서 실행 준비가 끝나지 않았기 때문이고, 노드를 정하지 못한 이유는 kubectl describe pod의 FailedScheduling 메시지에 나옵니다. 자주 나오는 메시지 다섯 가지의 뜻과 먼저 할 일, 고쳤는데도 Pending일 때 확인할 것을 정리했습니다.
장애 때 필요한 로그만 찾는 법, trace_id 활용 가이드
장애 때 필요한 로그는 요청마다 붙는 고유 식별자인 trace_id로 같은 요청에서 나온 로그만 모아 찾습니다. trace_id로 로그를 찾는 순서와 특정 서비스 로그가 빠졌을 때 점검할 곳을 먼저 보고, trace_id와 span_id, traceparent 헤더, correlation id의 역할을 정리합니다.
MTTR, MTBF, MTTD, MTTF 뜻과 차이, 계산법까지
MTTD는 감지까지, MTTR은 복구까지 걸린 평균 시간입니다. MTBF와 MTTF까지 네 지표의 뜻과 차이를 비교표로 정리하고, 한 달치 장애 기록으로 계산법과 가용성 계산을 예시로 보여 주고, MTTR과 MTBF 차이도 짚습니다.
OOMKilled와 Exit Code 137 원인과 해결 방법
쿠버네티스 메모리 부족으로 OOMKilled와 Exit Code 137이 남았을 때 확인할 kubectl 명령 3가지와 종료 패턴별 원인 4가지, limits와 JVM 힙 설정, replicas로 해결하는 방법을 정리했습니다. 137과 OOMKilled의 차이도 다룹니다.
Java GC 로그 보는 법, GC 일시정지로 응답 지연 원인 찾기
Java API 응답시간이 갑자기 느려질 때 GC가 원인인지 확인하는 방법입니다. jstat, jcmd로 상태를 보고 GC 로그를 읽어 정지 시간과 힙 사용량을 확인하고, GC 일시정지 구간을 응답 지연 구간과 비교한 뒤 Full GC 반복과 메모리 누수 신호를 가려냅니다.
모니터링 임계값 설정 가이드, 알림 기준은 어떻게 정할까?
정적 임계값과 동적 임계값(동적 기준선)은 무엇이 다를까요. 이동 평균, 표준편차 밴드, 퍼센타일, 계절성, 학습 기간으로 두 방식의 차이를 비교하고, 지표별 선택 기준과 지속 시간 조건까지 이상 탐지 알림 설계 방법을 정리했습니다.
LLM API 토큰 사용량 확인하는 3가지 방법
지금 토큰을 얼마나 썼고 한도까지 얼마나 남았는지는 제공사 콘솔, API 응답 본문, 응답 헤더 세 곳에서 각각 다르게 나옵니다. 세 곳의 차이와 캐시 토큰이 한도에 포함되는 기준, 호출마다 기록해야 할 값을 정리했습니다.
하이퍼바이저란? 뜻과 종류, Type 1과 Type 2 차이
하이퍼바이저란 무엇이고 Type 1(베어메탈)과 Type 2(호스트형)는 어떻게 다를까요? 두 종류의 비교표와 ESXi, KVM, Hyper-V 같은 대표 제품, 가상 머신과 컨테이너 차이, 메모리 오버커밋처럼 하이퍼바이저가 자원을 나눌 때 생기는 대기까지 정리했습니다.
RTO와 RPO란? 뜻과 차이, 재해복구(DR) 전략까지
RTO와 RPO 뜻과 차이를 비교표로 정리했습니다. NIST 기준 정의, 최대 허용 중단 시간(MTD)에서 RTO와 RPO를 계산하는 예시, 백업과 콜드 사이트, 웜 스탠바이, 멀티 리전 등 재해복구 전략별 복구 목표까지 담았습니다.
VMware 모니터링이란? VM이 느릴 때 확인해야 할 호스트 지표
VMware 환경에서 가상 머신이 느릴 때 원인은 호스트 쪽에 있을 수 있습니다. 게스트 지표에 잡히지 않는 CPU 준비 시간과 Co-Stop, 메모리 벌루닝, 디스크 지연, 하드웨어 상태를 증상별로 먼저 볼 곳과 함께 정리했습니다.
AI 에이전트 감사 로그, 사람과 에이전트 구분하기
AI 에이전트에 사용자 토큰을 그대로 주면 감사 로그에서 사람과 에이전트가 구분되지 않고 권한도 넓게 열립니다. 에이전트 신원과 권한 위임을 나누는 접근 통제 설계, 감사 로그에 남길 항목, MCP와 OAuth 토큰 교환 표준을 정리했습니다.
쿠버네티스 GPU 할당의 혁신: 노드 전체 격리 없이 장애 GPU만 제어하기
GPU 한 장이 고장나면 노드 전체를 비우던 방식이 v1.37에서 달라졌습니다. 쿠버네티스 GPU 스케줄링에서 DRA 디바이스 테인트로 장치 하나만 격리하는 방법과 갱 스케줄링의 minCount 동작, GenericWorkload 게이트 조건을 정리했습니다.
Continuous Profiling이란? CPU 병목을 코드 단위로 찾는 방법
Continuous Profiling은 실행 중인 코드 어디에서 자원을 쓰는지 남기는 방식입니다. 메트릭·로그·트레이스와 무엇이 다른지, OpenTelemetry Profiles가 알파 단계인 지금 eBPF 수집은 되는데 무엇이 아직 안 되는지 정리했습니다.