SingleStore モニタリング、何を見るべきか
分散SQLデータベースであるSingleStoreは、単一インスタンスDBとモニタリングの視点が異なります。アグリゲーターとリーフノードの構造で何を見るべきか、特にデータスキューとパイプライン遅延をどう捉えるかをまとめます。
こんにちは。AIネイティブなオブザーバビリティプラットフォーム、WhaTap(ワタップ)です。
同じクエリなのに、ある日は0.2秒、ある日は8秒かかる。単一データベースであれば、スロークエリログ一つで原因を絞り込めますが、SingleStoreのようにデータを複数ノードに分散して保存する分散SQLデータベースでは話が変わってきます。クエリは同じでも、データがノードごとに均等に分散しているか、特定ノードに偏っているかによって、応答時間が数十倍も変わってきます。
この記事は、SingleStore(旧MemSQL)を運用している、または導入を検討している開発者・DBA・SREを対象にしています。一般的なデータベースモニタリングではなく、分散SQLデータベースだからこそ追加で見るべきポイントを中心に整理します。ノード構成から始め、ストレージエンジン、データスキューと分散クエリ、パイプラインの順に見ていきます。
アグリゲーターとリーフノードは何が違うのか
SingleStoreクラスターは、役割の異なる2種類のノードで構成されます。アグリゲーター(aggregator)ノードは、クライアントのクエリを受け取って各ノードに振り分け、返ってきた中間結果をまとめてクライアントに返すルーターのような役割を担います。リーフ(leaf)ノードは、実際のデータを断片(Chunk)に分けて保存し、その上で演算を実行するストレージ兼演算ノードです。
アグリゲーターはさらに2つに分かれます。クラスター全体を統制しメタデータを管理するマスターアグリゲーター(master aggregator)が1つあり、クエリ負荷を分散して受けるチャイルドアグリゲーター(child aggregator)が複数付きます。クライアント接続とクエリの入口は主にアグリゲーター側に集中し、CPU・メモリ・ディスクを実際に多く使うのは、データを保持しているリーフノードです。
この構成のため、モニタリングの第一歩はノードごとのリソース使用量を分離して見ることです。アグリゲーターのCPUが跳ね上がっているなら結果のマージやクライアント接続側の負荷を疑い、特定のリーフノードだけCPUとメモリが高いなら、そのノードにデータまたはクエリ負荷が偏っているというサインです。ノードを1つの平均値にまとめて見てしまうと、こうした偏り(Skew)が平均の中に埋もれて見えなくなります。
クラスターのヘルスを見る際は、ノードリストが実際の構成と一致しているかをまず確認します。SingleStoreはクラスターメタデータビュー(MV_NODES)で現在生きているノードとその役割を照会でき、リーフノードが1つ欠落したり応答がなかったりする場合にすぐ把握できます。リーフノードが1つ欠けるとデータの再分配が発生し、その過程でクエリ性能が一時的に不安定になることがあります。したがって、ノード数の変化とリソース使用量を併せて見ることをおすすめします。
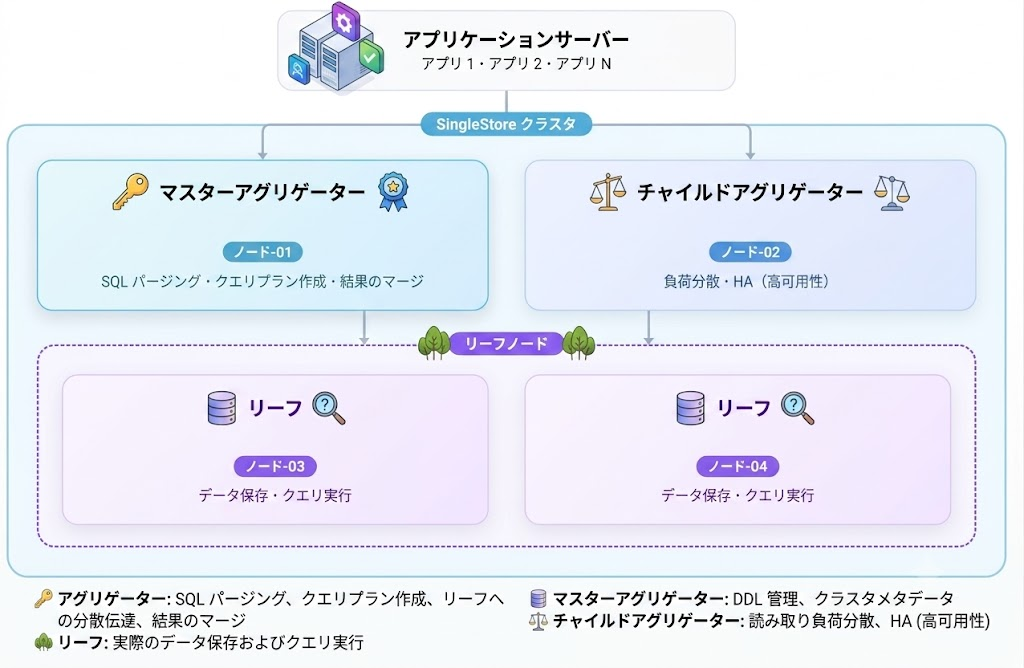
アグリゲーターとリーフノードで構成されたSingleStoreクラスタアーキテクチャ
データスキュー、分散SQL DBの性能を左右する手がかり
分散SQLデータベースのモニタリングでもっとも重要でありながら見落としやすい指標が、データスキュー(data skew)です。データスキューとは、テーブルのデータがクラスターのパーティションに均等でなく分布している状態を指します。SingleStoreはリーフノードをさらにパーティション(partition)という単位に分割し、各パーティションがデータの一部(シャード)を保持します。
どの行がどのパーティションに入るかは、シャーディングキー(shard key)が決めます。INSERTが入ると、アグリゲーターがシャーディングキーのカラム値にハッシュ関数を適用してパーティション番号を計算し、該当パーティションへ行を送ります。そのため、シャーディングキーの値が同じ行は常に同じパーティションに集まります。
問題は、シャーディングキーの分布が一方に偏っている場合です。たとえばECサイトで大手顧客1社が全注文の40%を占めていると、その顧客のデータが特定のパーティションに集中します。他のパーティションに余裕があっても、そのパーティションひとつがボトルネックになることで、全体のクエリ時間が引きずられて延びることがあります。このようにパーティション間でデータが不均衡に分布した状態を、パーティションスキュー(partition skew)と呼びます。
スキューがなぜ性能を直接落とすのかは、分散クエリの動作方式に理由があります。複数のパーティションにまたがるクエリは、もっとも遅いパーティションより速くはなりません。すべてのパーティションの結果が揃って初めて、アグリゲーターが最終結果を出せるからです。行が1つのパーティションに偏っていると、そのパーティションの処理時間が全体のクエリ時間を左右し、他のパーティションは早く処理を終えたまま待つことになります。同じクエリがある日だけ遅くなる現象の多くは、ここに原因があります。
そのため見るべき指標は、単純な総行数ではなく、パーティションごとの偏差です。
パーティション別の行数の偏差: パーティションごとの保持行数がどれだけ開いているか。特定の1〜2パーティションだけ突出して大きい場合は、シャーディングキーの分布を疑います。
パーティション別のバイト(メモリ)偏差: 行数が近くても、行のサイズが異なればメモリ占有が一方に偏ることがあります。メモリスキューは特定のリーフノードのメモリ逼迫につながります。
ノード間のデータ量偏差: パーティションがノードに均等に配置されているのか。1つのノードに大きなパーティションが集中すると、そのノードがクラスターのボトルネックになります。
スキューを検出した際の一般的な解決方向は、シャーディングキーを選び直すことです。SingleStore公式ドキュメントは、シャーディングキーにカラムを追加して分布をより均等にするか、あるいはデータを再分配する方法を推奨しています。ただしキー変更は再格納を伴うため、稼働中のクラスターではスキューの推移を継続的に観察し、しきい値を超える前に対応するほうが安全です。
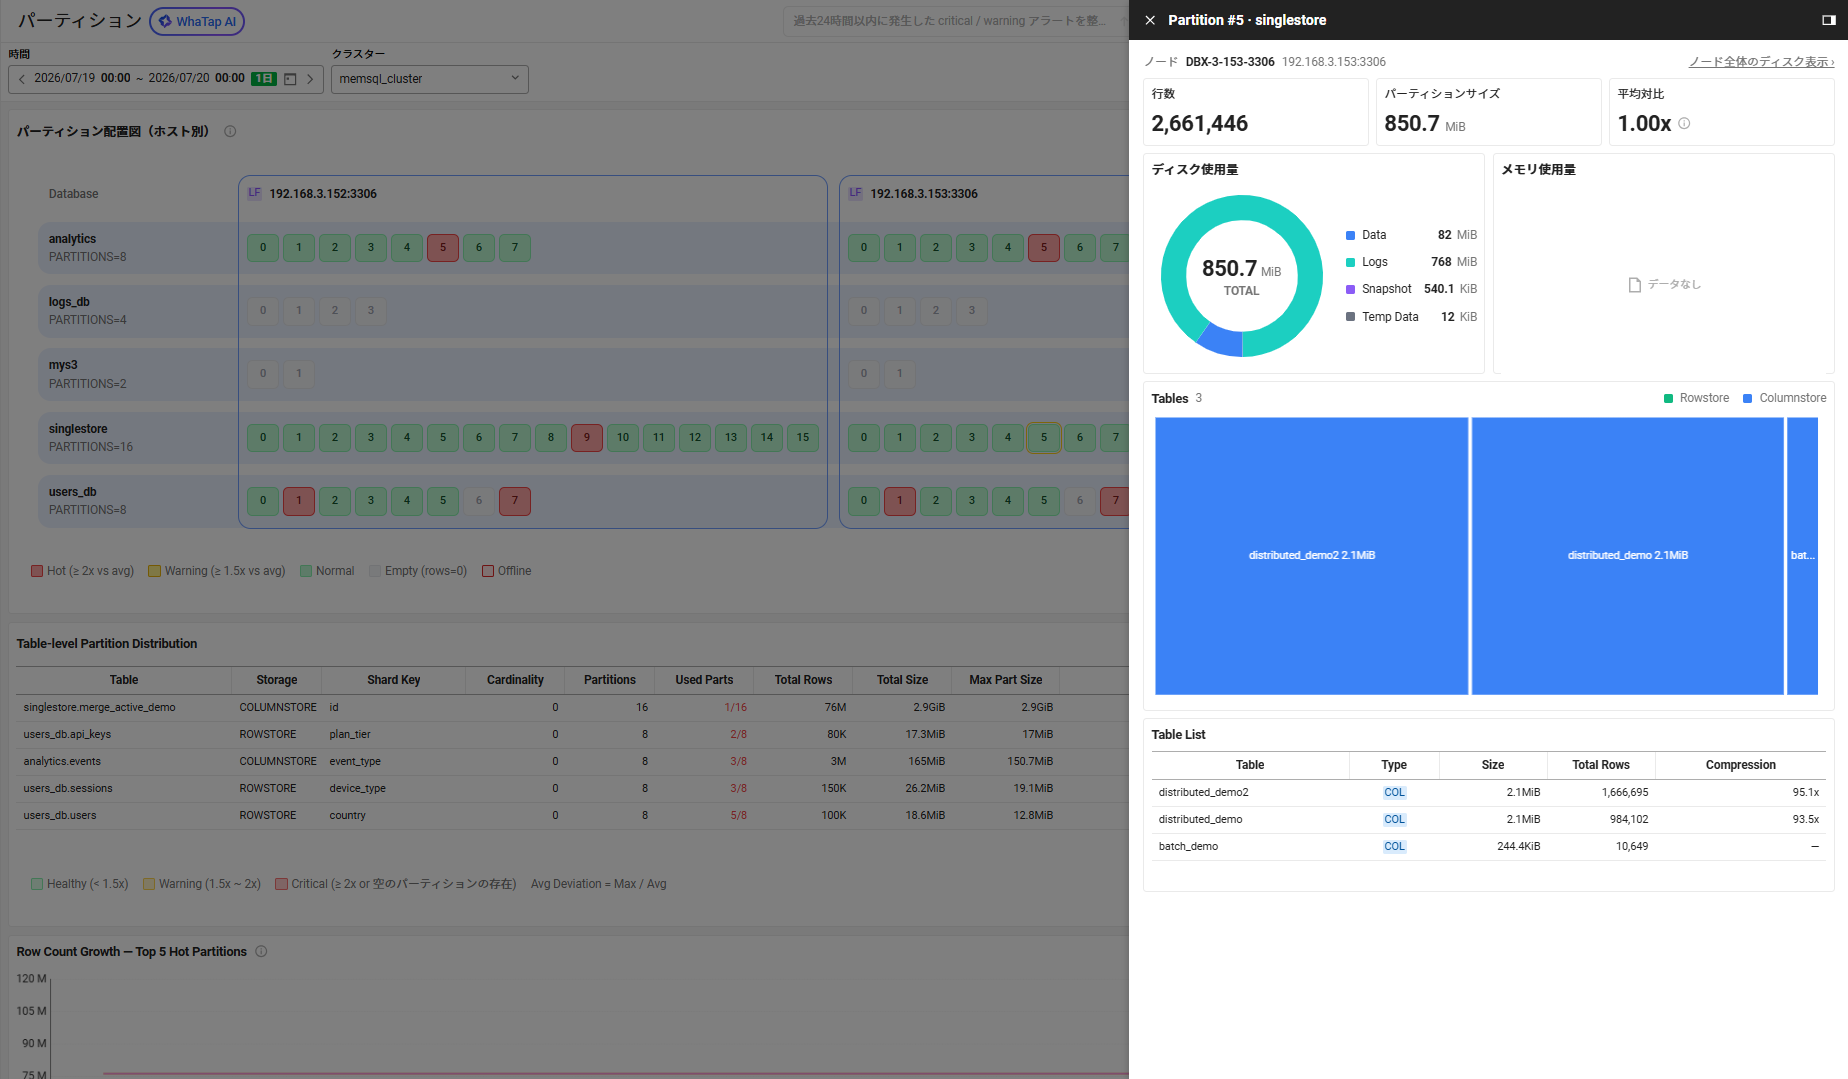
スキュが発生したパーティションと原因となったシャーディングキーを分析する画面の例
分散クエリが遅いとき、どのノードを見るべきか
SingleStoreはMySQLワイヤープロトコルと互換性があり既存のMySQLツールで接続できますが、スロークエリを見る視点は分散環境に合わせる必要があります。単一DBでは「このクエリが遅い」で終わりますが、分散SQLデータベースでは「このクエリがどのノード、どのパーティションで遅いのか」まで掘り下げて初めて原因がつかめます。
カラムストアとロウストア、どちらの負荷か
クエリがどのストレージエンジンを通るかから見極めます。SingleStoreは1つのクラスターの中で2種類のエンジンを併用します。カラムストア(columnstore)はデータをカラム単位でディスクに保存し、大量集計や分析クエリに強く、ロウストア(rowstore)は1行のすべてのフィールドをメモリに保持し、短時間のトランザクションやポイント参照に高速です。SingleStore Heliosではカラムストアが標準のテーブル形式で、ロウストアはすべてメモリに載ります。
この2つを合わせてユニバーサルストレージ(Universal Storage)と呼びます。ユニバーサルストレージは、カラムストアが進化する過程で、行単位のロック・ハッシュインデックス・アップサートといったトランザクションワークロードもカラムストア上で処理できるようになった形態です。おかげで、トランザクションと分析を1つのデータベースで同時に処理するHTAP(Hybrid Transactional/Analytical Processing、トランザクションと分析ワークロードを1つのシステムで同時に処理する方式)が可能になりました。
ただし、モニタリングの観点では、2つのエンジンのボトルネック箇所は依然として異なります。ロウストアはメモリに常駐するため、テーブルが大きくなるほどリーフノードのメモリ使用量がまず問題になります。メモリ使用量が上限に近いのにディスクに余裕がある場合は、ロウストアテーブルの増加をまず疑います。反対にカラムストアは、ディスクI/Oとセグメントのマージ負荷が主に現れます。HTAPとして運用しているなら、同じクラスターで分析クエリがトランザクションの応答時間を押し出していないか、ワークロードごとのリソース占有を切り分けて見ることが要点です。
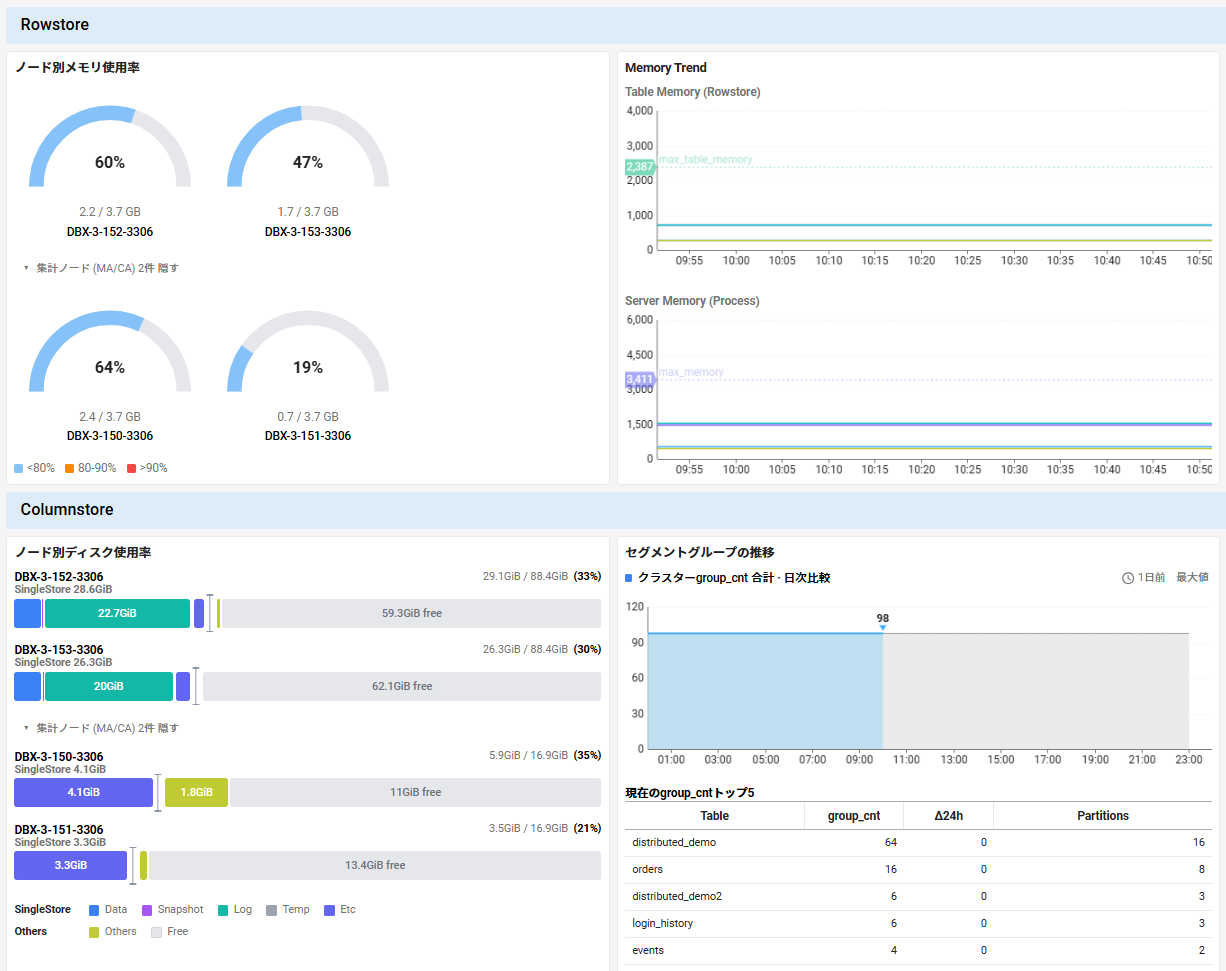
ロウストアとコラムストアの状態とリソース使用を比較して表示するストレージエンジン画面
実行計画とアクティブセッションで遅延箇所を絞り込む
分散クエリは、アグリゲーターが実行計画を立てて各リーフノードに作業を振り分け、リーフが自分のパーティションで処理した中間結果を、再びアグリゲーターがまとめる流れです。そのため、クエリ実行計画を見る際は、作業が単一パーティションに収まるのか、複数パーティションに分散するのかが最初の分かれ道になります。シャーディングキーと完全に一致する条件は単一パーティションにルーティングされ高速ですが、シャーディングキーを利用できない検索はすべてのパーティションを走査し、ノード間のデータ移動(リパーティショニング)を引き起こして遅くなります。
リアルタイム診断では、アクティブセッション、つまりいまこの瞬間実行中のクエリをノード別に見ることが出発点です。どのリーフノードに実行中のクエリが滞留しているかを見れば、負荷が偏っているノードと、そのノードで動いているSQLをすぐに絞り込めます。特定のリーフだけでアクティブセッションが長く滞留している場合は、先述のデータスキューやそのノードのリソース飽和も併せて疑います。
ロック競合、待機、デッドロックも分散環境でそのまま現れます。ただし、ロックがどのノード、どのセッション間で発生しているかを分散の観点で追跡する必要があります。どのセッションが何を待っていて、誰がリソースを保持しているかをノードと紐づけて見ることで、あるトランザクションが長く保持し続けたせいで後続の作業が連鎖的に詰まっている状況を解きほぐせます。
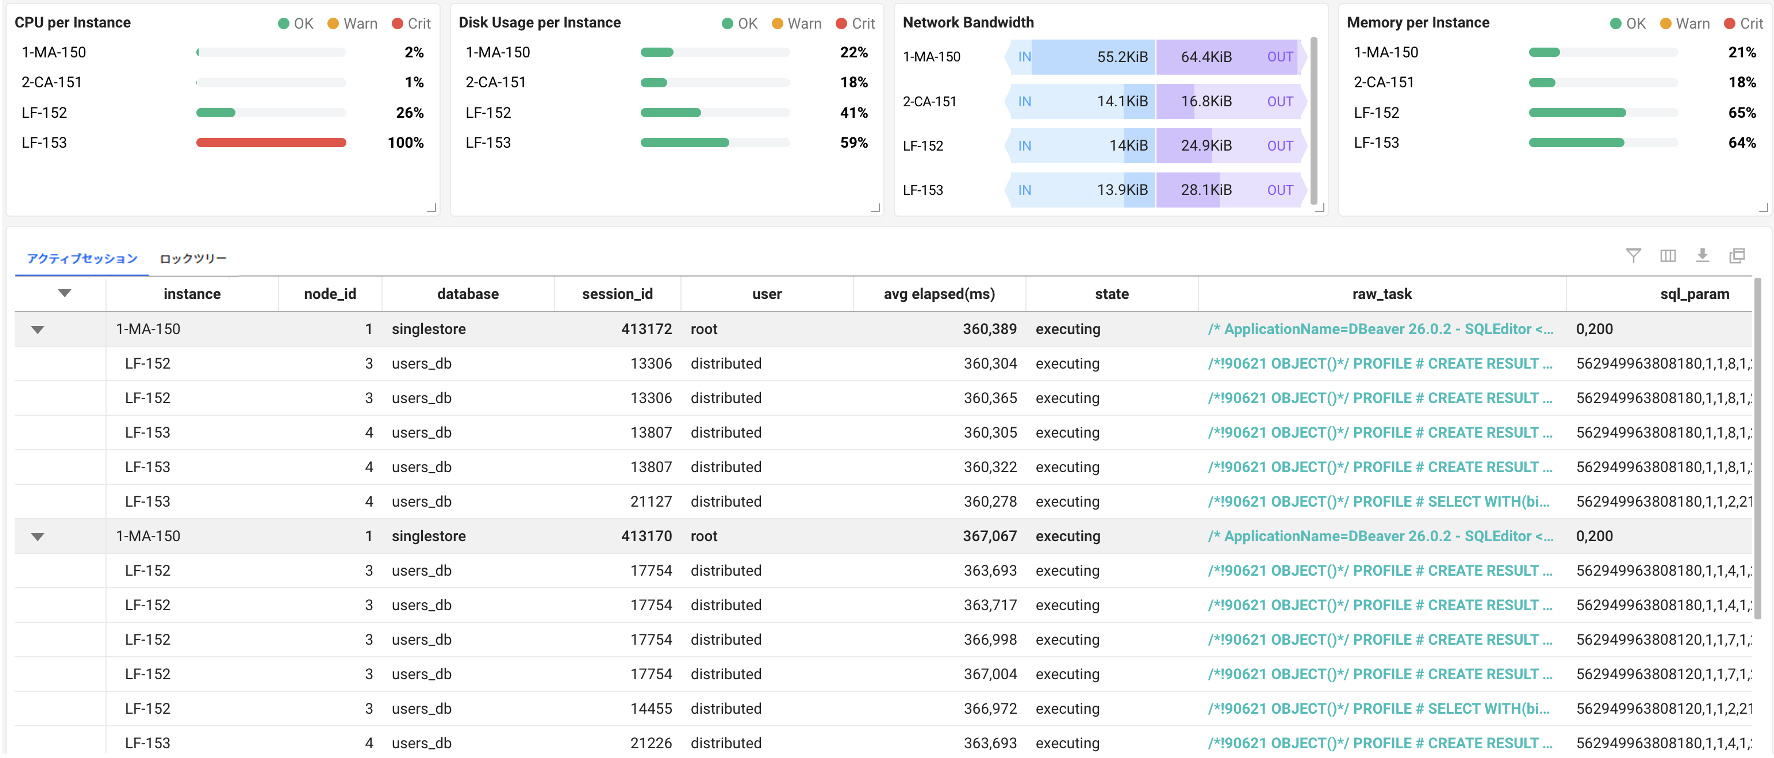
アグリゲーターが送信した作業をどのリーフノードが実行中かをノードごとに表示する マルチインスタンス画面の例
📌 こんな場面で有効!(SingleStore導入検討中の開発側) 単一インスタンスDBの経験だけだと、「クエリが遅い」の次に「どのノードが遅いのか」を確認する発想自体が抜けがちです。分散SQL DBでは、まずノード別の指標を見る習慣をつけることが、単一DBの経験からの一番大きな視点転換になります。
パイプライン遅延、リアルタイム取り込みのヘルスシグナル
SingleStoreには、SingleStore Pipelines(SingleStoreパイプライン)というデータ取り込み機能があります。Apache Kafkaのようなソースから大量のデータを高いスループットで、正確に一度(exactly-once)の意味論でデータベースに流し込む機能です。リアルタイム取り込みをパイプラインに任せている構成であれば、パイプラインが詰まった瞬間、ダッシュボードが見ているデータもそれだけ過去のものになります。
パイプラインで見るべきシグナルは、遅延とバッチの状態です。ソースに入ってきたデータと実際の取り込みの間の時差が開くと、ダッシュボードや分析クエリが見ているデータがそれだけ過去のものになります。バッチが繰り返し失敗したり、リトライが積み重なったりすると取り込みが詰まり、遅延が蓄積します。パイプラインが処理中に使うメモリも併せて見る必要があります。取り込み負荷がリーフノードのメモリ使用量を押し上げ、他のクエリとリソースを奪い合うことがあるためです。
パイプラインは、ソースから取り込み完了までを1つの流れとして捉え、どの段階で詰まっているかを追跡することが要点です。取り込み遅延が単純にソースの流入量増加によるものか、特定のリーフノードの飽和によるものかを見極めるには、先に見たノード別のリソースとスキュー指標を併せて見る必要があります。
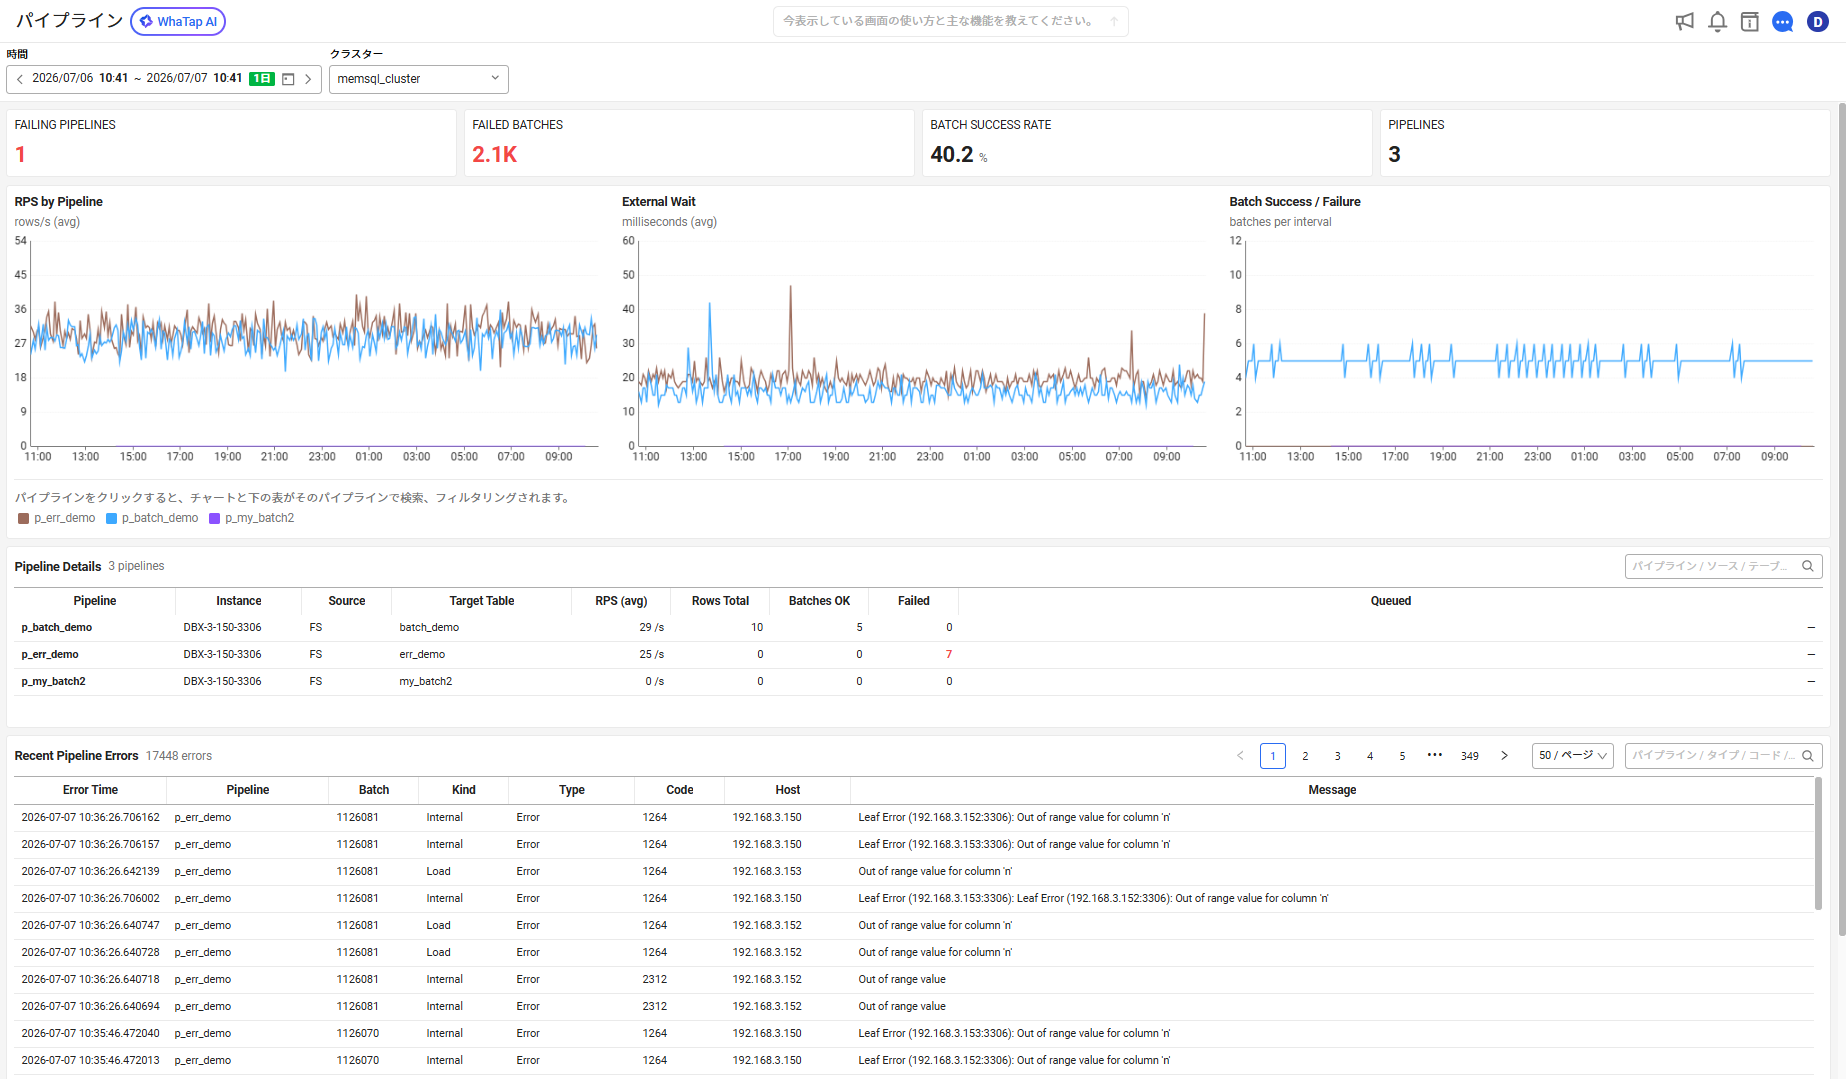
積載の流れの遅延とバッチ状態を追跡するパイプライン画面の例
📌 こんな場面で有効!(SRE/インフラ運用側) パイプラインの遅延は、往々にして「データが古い」というふわっとした違和感として最初に気づかれます。ソース流入量、バッチ失敗率、リーフノードのメモリ使用率の3つを1画面で並べて見られるようにしておくと、違和感を数値で裏づけるまでの時間を大きく縮められます。
おわりに
SingleStoreのような分散SQLデータベースを見るときは、単一インスタンスDBの平均指標だけでは不十分です。核心は、平均に隠れた偏りを浮かび上がらせることです。ノードごとにリソースを分けて見て、パーティションごとの行数とメモリの偏差でデータスキューを捉え、分散クエリがどのノード、パーティションで遅いのかまで掘り下げ、パイプライン遅延を取り込みの流れ単位で追跡すること。これが分散環境モニタリングの骨子です。SingleStoreでは、「遅いSQLは何か」よりも「どのリーフノードで、なぜ遅くなったのか」を先に問うことが、分散環境に合ったアプローチです。
SingleStoreを運用している、または導入を検討しているなら、これらのポイントを一つの画面でノードごとに切り分けて見られるかどうかを基準にモニタリングツールを検討するとよいでしょう。WhaTapは、アグリゲーターとリーフノードの構成を自動認識し、ノード別リソースとデータスキュー、分散クエリ、パイプライン状態を統合画面で表示するSingleStoreモニタリングを提供しています。
WhaTapを初めてご利用の方は、無料トライアルからお試しいただけます。